Ceph, ZFS-replikering og et eksternt SAN eller NAS kan hjælpe Proxmox-VM’er gennem værtsnedbrud. De giver dog forskellig dataaktualitet, genstart og fejldomæne. Kun at afkrydse »høj tilgængelighed« skjuler ofte kravet: hvor mange minutters datatab tåler applikationen (RPO), og hvornår skal den kunne bruges igen (RTO)?
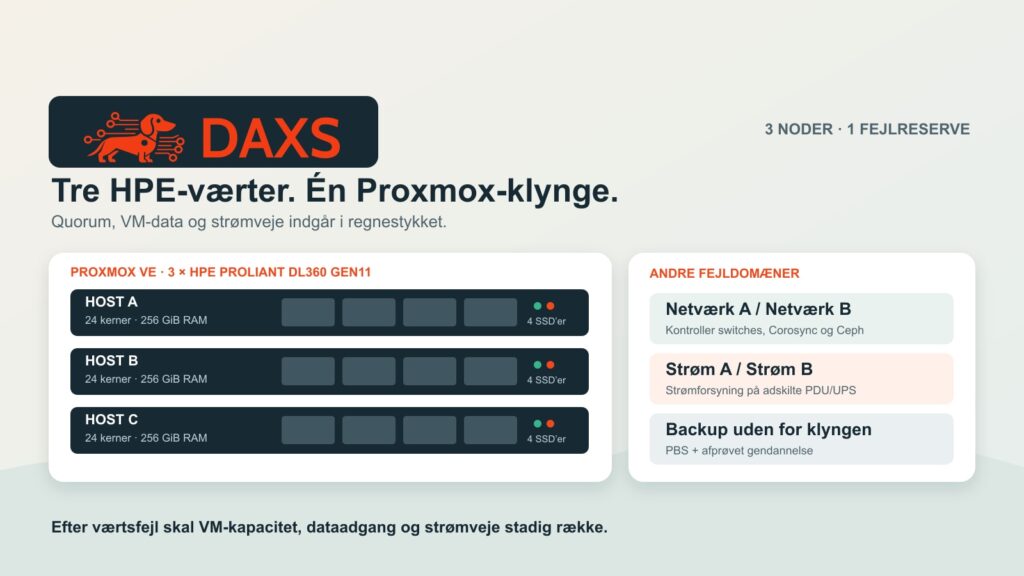
Vi sammenligner tre lagerveje for samme hypotetiske klynge med tre værter. Hvordan Ceph genopbygger kopier efter værtsnedbrud beskrives separat. Valget begynder her med applikationerne og deres dokumenterbare genopretningsmål. Separat backup med gendannelsestest kræves desuden i alle tre tilfælde.
Tre arkitekturer, tre forskellige fejlforløb
Ceph på lokale SSD’er leverer VM-disken som distribueret bloklager, der er fælles tilgængeligt i klyngen. En replikeret pool har kopier på flere værter; quorum, poolregel, netværk og fri kapacitet skal passe til værtsfejldomænet. Efter en VM-værts nedbrud kan Proxmox HA genstarte VM’en på en anden vært, hvis quorum og ressourcer er tilgængelige. Igangværende skrivning, gæsteapplikation og transaktioner skal stadig vurderes i testen. Ceph-redundans alene lover hverken uafbrudt VM eller garanteret RPO nul for alle applikationer.
Lokal ZFS med Proxmox-lagerreplikering overfører VM-volumener med snapshots i intervaller til en anden vært. Målet har tilstanden fra den senest vellykkede og afsluttede replikering. Proxmox tillader HA sammen med replikering, men advarer udtrykkeligt om datatab siden sidste synkronisering. Et indstillet femminuttersinterval er derfor intet generelt RPO-løfte: forsinkelse, fejlede jobs og applikationstilstand tæller med. Uden synkron fælles disk skal den genstartede VM kunne håndtere netop denne ældre tilstand.
Eksternt fælles lager som NFS eller iSCSI gør VM-diske tilgængelige for flere værter og tillader typisk live-migrering uden diskkopi. Ved værtsnedbrud afhænger datarisikoen af lagerets konkrete design. Kontroller to controllere, separate data- og strømveje, iSCSI-multipathing eller redundante NFS-netveje, support og testet controllerfailover; ét NAS er fortsat et centralt fejldomæne. Proxmox advarer udtrykkeligt mod, at en ZFS-over-iSCSI-enhed bliver single point of failure. »Shared« i konfigurationen beviser ingen redundant appliance.
Hvilken workload tåler hvilke RPO og RTO?
RPO måler maksimalt accepteret datatab, RTO den maksimale tid til en brugbar applikation. Følgende er beslutningsspørgsmål, ikke produkt-SLA’er. For hver tjeneste skal database, VM-genstart, DNS, brugerlogin og afhængige systemer testes sammen.
| Applikation og mål | Plausibel vej | Afgørende kontrol |
|---|---|---|
| Transaktionel ERP-database; næsten intet datatab tåles | Ceph eller dokumenteret redundant fælles lager; eventuelt også applikationsreplikering | Skrivelatens, transaktionskonsistens, quorum og reel genstart ved værts-/lagerfejl |
| Intern test-VM eller gendannelig webtjeneste; minutters datatab accepteres | Lokal ZFS med replikering kan række | Alder på sidste vellykkede snapshot, alarm ved forsinkelse, start med ældre data |
| Eksisterende supporteret SAN/NAS med tilstrækkelig reserve | Fortsat brug som fælles lager kan være økonomisk | Test controllere, veje, strøm, firmware, vedligeholdelsesaftale og live-failover sammen |
For en produktionsdatabase med meget stramt RPO kan asynkron ZFS-replikering være uegnet, selv om HA-genstart virker. Omvendt retfærdiggør en gendannelig testtjeneste ikke automatisk Ceph. Tre Proxmox-værter gør ikke én lagerserver redundant. Valget følger accepteret datatab og målt afbrydelse frem for produktnavnet alene.
Tre- og femårsberegning uden opdigtede markedspriser
Sammenligningen antager tre identiske enkeltsokkelværter med købspris h pr. vært og en separat backupserver med medier til pris b . Ifølge producentens aktuelle liste koster Proxmox VE Standard 550 € pr. bestykket CPU-sokkel om året, Proxmox Backup Server Standard 2.240 € pr. server om året. Den fælles supportblok er dermed 3 × 550 + 2.240 = 3.890 € årligt. Modellen bruger 90 € netto pr. arbejdstime. Den antager ikke ukontrolleret ens IOPS eller brugbar kapacitet: reelle tilbud skal først normaliseres til samme workload.
d står for ekstra Ceph-data-SSD’er pr. vært, z for lokal ZFS-SSD-udrustning pr. vært, a for en redundant designet ekstern appliance, nc, nz og ns for de nødvendige netværks- eller fabricinvesteringer i hver løsning. ec, ez og es er årlige ekstra strøm-/colocationomkostninger; s er den eksterne appliances årlige producentserviceaftale. Alle bogstaver er nettotilbudsbeløb i euro, ikke påståede markedspriser.
| Vej | Opbygning / årlig drift | 3 år | 5 år |
|---|---|---|---|
| Ceph | 80 h / 50 h | 3h + b + 3d + nc + 32.370 + 3ec € | 3h + b + 3d + nc + 49.150 + 5ec € |
| ZFS-replikering | 50 h / 30 h | 3h + b + 3z + nz + 24.270 + 3ez € | 3h + b + 3z + nz + 37.450 + 5ez € |
| Eksternt lager | 60 h / 35 h | 3h + b + a + ns + 26.520 + 3s + 3es € | 3h + b + a + ns + 40.600 + 5s + 5es € |
Arbejdstimerne er rene modelantagelser, ikke en DAXS-fastpris. Eksempel: 1.000 € mere årlig applianceservice øger den eksterne variant med 3.000 € over tre år og 5.000 € over fem. En eksisterende appliance kan sænke a i perioden, men restlevetid, support, reservedele og udvidelser hører i s eller et separat investeringsfelt. Hardwarepriser, lagerforbrug, ydelsesprofil, netværk, skat og driftssted skal dokumenteres med tilbud. Laveste formelværdi er ingen købsbeslutning uden ens brugbar kapacitet, IOPS, RPO og RTO.
Godkendelse: gennemspil faktisk én fejl pr. fejldomæne
DAXS ville kræve fire beviser for hver mulig arkitektur: (1) registrer tidspunktet for sidste konsistente applikationstilstand, (2) mål værtsnedbrud og VM-genstart under belastning, (3) afbryd også den kritiske lager- eller netværksvej og (4) gendan en VM og enkelte applikationsdata fra separat backup. Medtag ved ZFS et fejlet eller forsinket replikeringsjob; ved Ceph den degraderede pool og genopbygning; ved SAN/NAS controller- og vejskift. Målingerne afgør, om RPO og RTO nås.
Ceph-kopier, replikeringssnapshots og arrayspejling viderefører også sletninger og fejlagtige data. De erstatter ikke versionering, ekstern kopi eller gendannelsestest. DAXS-artiklen Proxmox Backup Server: verificering, opbevaring og gendannelse uddyber backupgodkendelsen. Med en applikationsliste og RPO/RTO-mål kan man via Kontakt lade DAXS måle de tre veje mod reel belastning og eksisterende aftaler.
Kilder: Proxmox VE Administration Guide: lager, lagerreplikering og HA · Proxmox VE: aktuelle supportpriser · Proxmox Backup Server: aktuelle supportpriser.